Cómo diseñar dashboards operativos en tiempo real
Cómo diseñar dashboards operativos en tiempo real: jerarquía, alarmas, estados, datos desactualizados y decisiones de interfaz. Caso SIAC B2B.
Imagina que un sensor deja de enviar señal en una instalación. Un dashboard operativo funciona si ayuda a localizar ese activo, confirmar si el dato es actual y decidir qué hacer; no funciona si sigue mostrando el último valor en verde.
En este artículo explico cómo diseño dashboards de monitoreo para operaciones donde un incidente se atiende en minutos. El caso que uso es SIAC, el rediseño de una plataforma de monitoreo industrial, y también lo reviso con ojo crítico.
¿En qué se diferencia un dashboard operativo de un reporte?
En la pregunta que responde. Un reporte o un dashboard analítico responde "¿qué pasó y por qué?": se revisa con calma, compara periodos y busca causas. Un dashboard operativo responde "¿qué está pasando ahora y requiere que alguien intervenga?". Stephen Few lo planteó hace años al distinguir los dashboards para monitorear de las herramientas para analizar.
La diferencia cambia todo el diseño. En un reporte, un gráfico más es información extra. En una consola operativa, un gráfico más es algo que compite con la alarma que importa. Pueden convivir un modo de supervisión y uno de exploración, pero el segundo nunca debería entorpecer al primero.
¿Qué debe mostrar primero un dashboard de monitoreo?
El estado general, después las excepciones y recién después el detalle. Uso como guía el modelo de conciencia situacional de Mica Endsley, que distingue tres niveles: percibir los elementos relevantes, comprender su significado y proyectar lo que puede pasar. Llevado a un dashboard:
- Percepción: ¿qué activo cambió y cuándo? Estado inequívoco, última señal y ubicación.
- Comprensión: ¿qué significa y qué más afecta? Severidad, alarma asociada, dependencias y tendencia.
- Proyección: ¿qué pasa si nadie actúa? Contexto, riesgo y procedimiento, sin prometer predicciones que el sistema no hace.
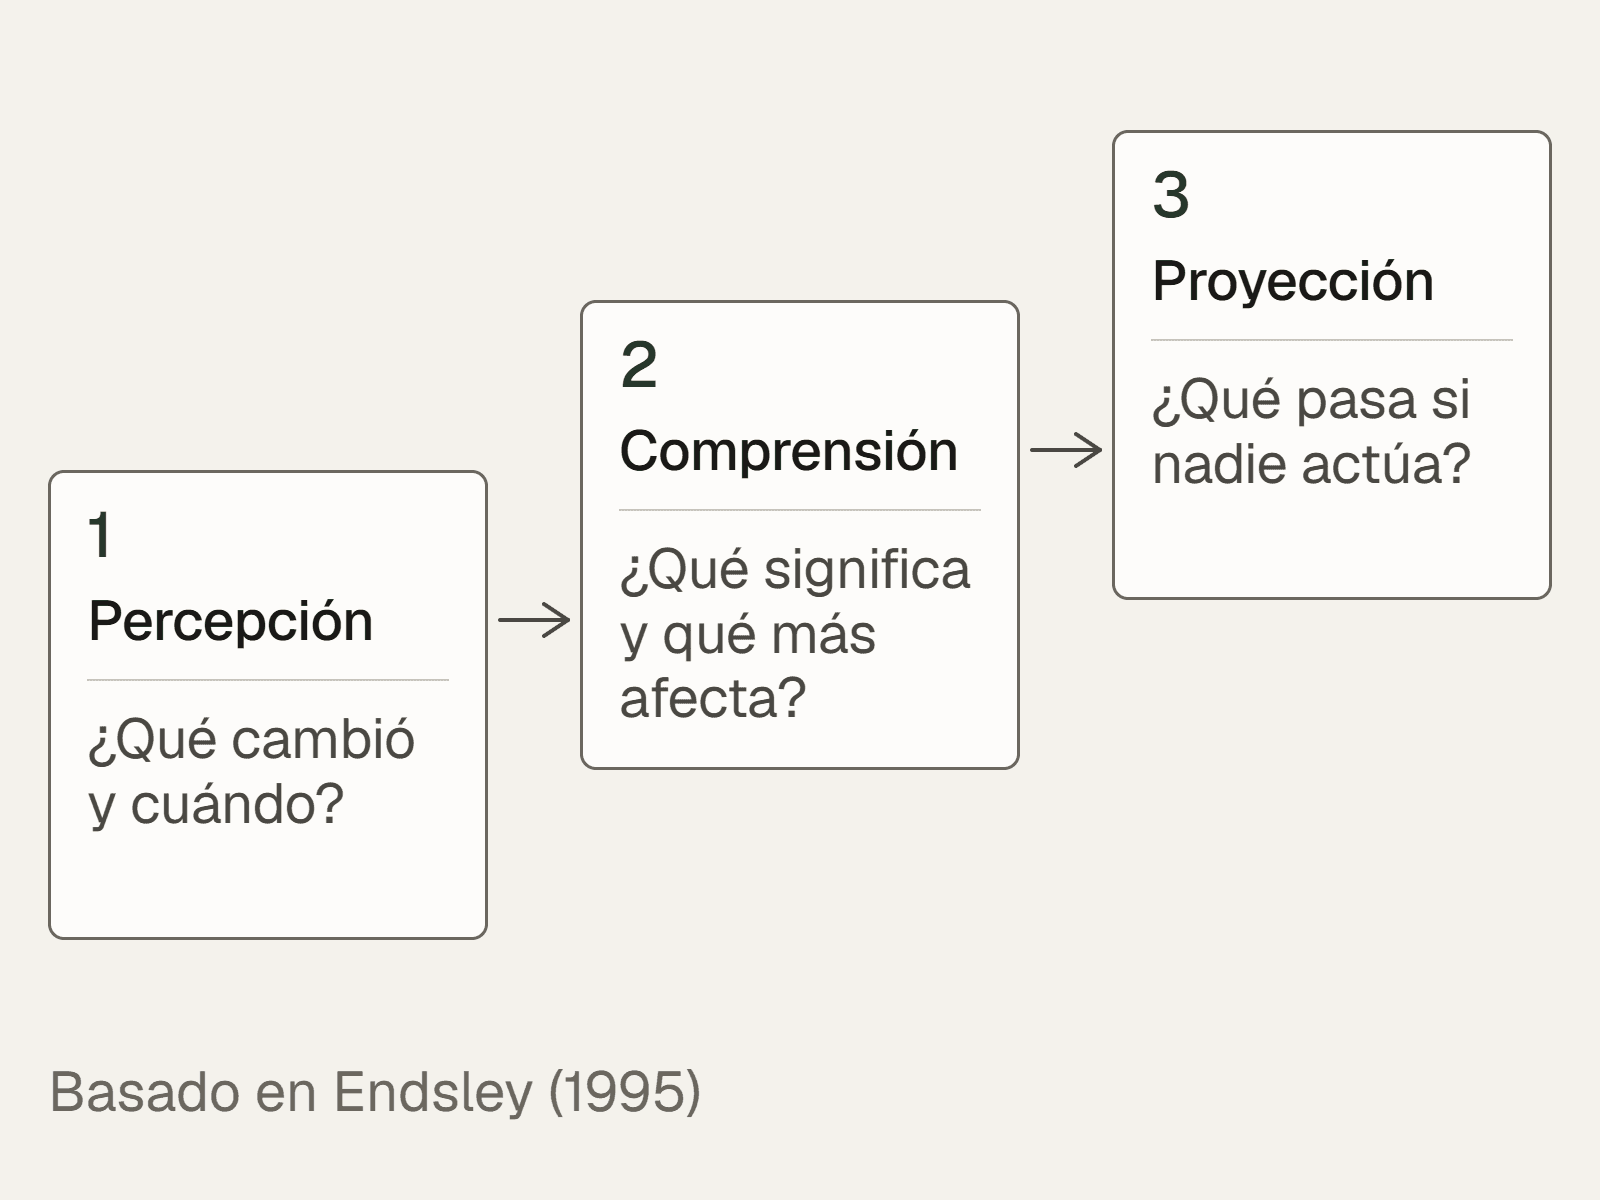
En la industria de procesos, la serie de normas ISA-101 sobre interfaces humano-máquina trata la estructura de pantallas como parte del ciclo de vida del HMI, y especialistas como Yokogawa describen jerarquías de hasta cuatro niveles de pantalla, de la vista general a la de diagnóstico. Mis tres niveles no son esa jerarquía técnica, sino una forma de ordenar las preguntas del operador; comparten la idea de que lo que requiere atención se encuentra sin recorrer todo.
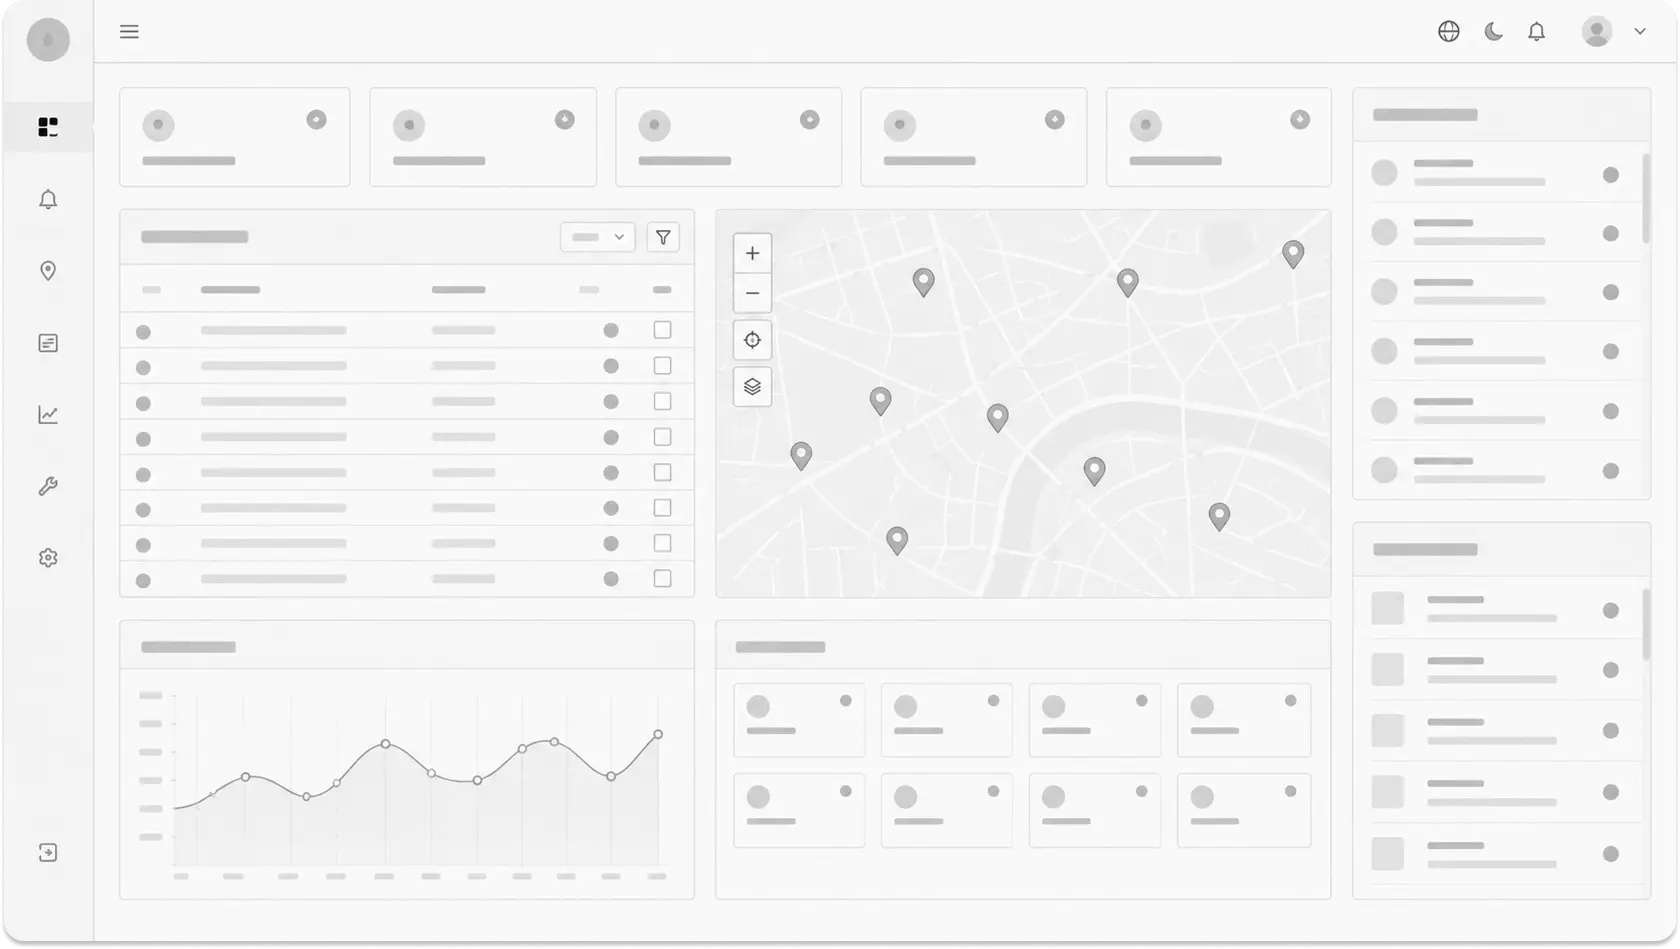
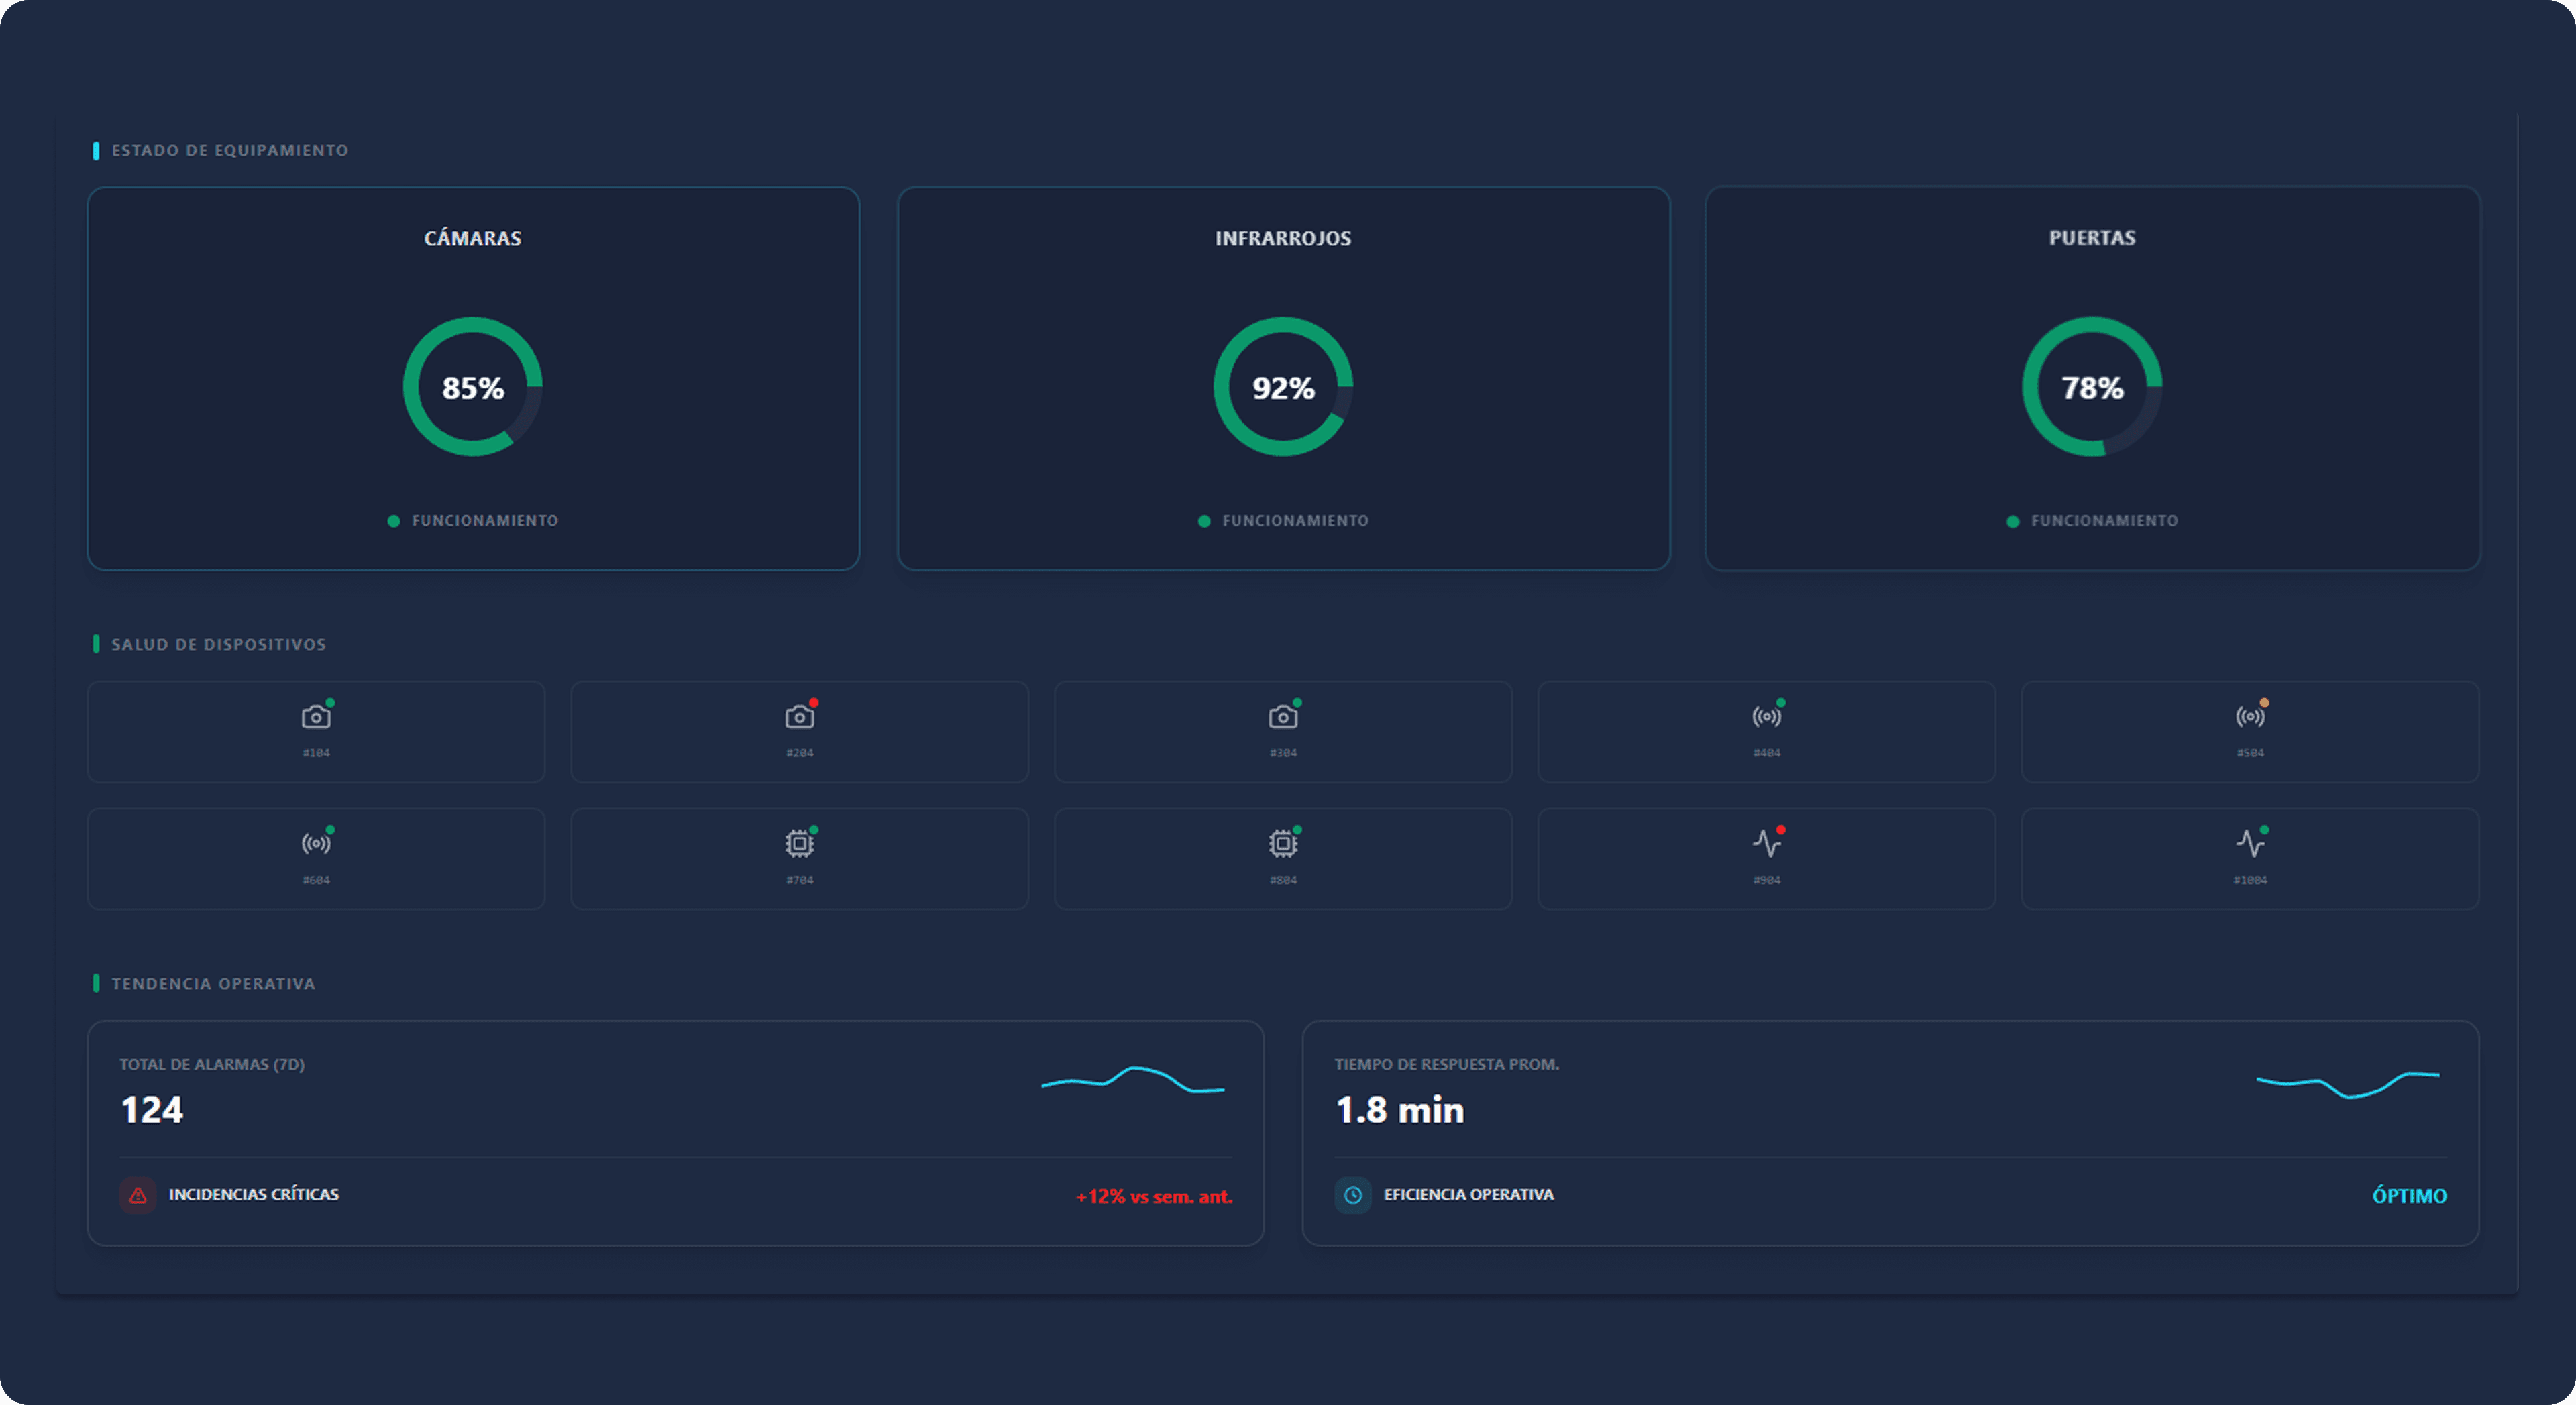
En SIAC, el primer paso fue exactamente ese. El wireframe de baja fidelidad pone en una sola vista los KPIs por tipo de activo, el listado de alarmas, el mapa y las tendencias, para decidir qué se lee primero antes de discutir colores.
¿Cómo diferenciar estados de dispositivos sin depender solo del color?
Combinando tres señales: una palabra visible, un ícono o forma y un color. Las WCAG lo exigen desde el nivel más básico: el color no puede ser el único medio para transmitir información. Y en una sala de control hay una razón operativa además de la de accesibilidad: con poca luz, en una pantalla compartida o bajo presión, dos tonos parecidos se confunden.
Uno de los problemas que encontré en SIAC fue precisamente ese: estados de dispositivos con colores similares y poco contraste. La respuesta fue un sistema de tokens propio, siac-*, alineado a seis estados operativos reales: armado, activo, desarmado, alarmado, bloqueado y apagado. En los componentes, el estado aparece con color y con etiqueta de texto; en el mapa, con pines que tienen ícono por tipo de dispositivo y una leyenda de estados.
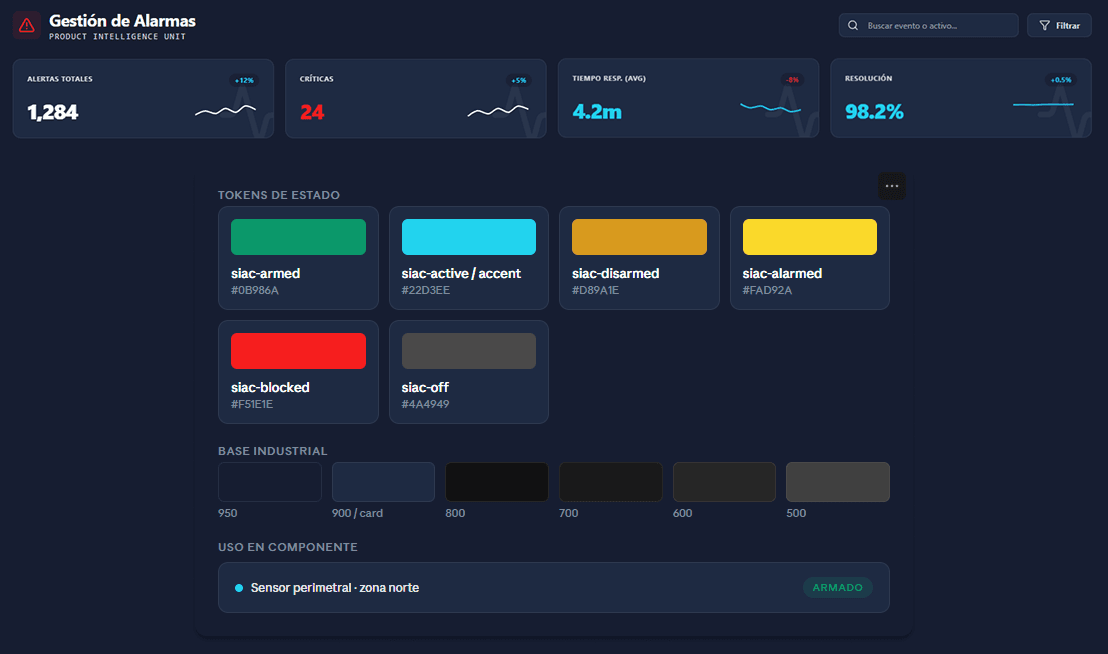
Hoy le agregaría dos cosas. La primera es asignar a cada estado un peso visual según si pide acción, no solo un color distinto. La tabla es una propuesta para validar con operación, no lo que está implementado:
| Estado en SIAC | ¿Pide acción? | Peso visual propuesto | Refuerzo además del color (a validar) |
|---|---|---|---|
| Alarmado | Sí, ahora | Máximo: superficie y contraste altos | Ícono de alerta y etiqueta |
| Bloqueado | Probablemente | Alto | Ícono de prohibido y etiqueta |
| Desarmado | Depende de la operación | Medio: cambia la protección | Forma distinta a la de alarmado |
| Apagado | Verificar si es esperado | Bajo, pero distinto de "sin señal" | Ícono de apagado |
| Activo | No | Bajo | Ícono de actividad |
| Armado | No | Bajo | Ícono de escudo |
La segunda es separar el estado del dispositivo del estado del dato, que explico más abajo.
¿Cómo priorizar alarmas sin saturar al operador?
Distinguiendo cuatro cosas que muchas interfaces mezclan:
- Evento: queda registrado, no pide atención.
- Aviso: tiene que verse, pero no interrumpe.
- Alarma accionable: tiene prioridad, responsable, contexto y una siguiente acción.
- Falla de datos: no hay forma de saber qué pasa; es un problema de observabilidad, no del activo.
Cuando todo es alarma, nada lo es. La gestión de alarmas en la industria de procesos tiene normas propias: ISA-18.2 la trata como un ciclo de vida que incluye identificar, racionalizar, implementar, operar y monitorear las alarmas, y EEMUA 191 publicó en 2024 su cuarta edición. Como referencia de inundación, un artículo técnico de ISA usa como indicador que un operador reciba más de diez alarmas en diez minutos. Esa cifra es para sistemas de control de procesos por operador; no la trasladaría tal cual a cualquier plataforma IoT, pero sirve para dimensionar el problema.
El fenómeno es el mismo que describo en human in the loop para agentes de IA: cuando todo pide atención, la persona deja de mirar. Las alarmas y las aprobaciones comparten la solución de fondo: priorizar por impacto y reservar la interrupción para lo que la merece.
Dos precisiones de diseño. Reconocer, silenciar temporalmente y resolver una alarma no son sinónimos: cada acción necesita una semántica y una trazabilidad propias, definidas con operación. Y una alarma crítica nunca debería depender de una notificación efímera: IBM Carbon diferencia tipos de notificación según cuánto interrumpen y cuánto persisten, y un toast que desaparece no es un canal para un incidente.
¿Cuánto tiempo real necesita cada dato?
Menos del que se suele pedir, pero con una condición: que la interfaz diga cuándo un dato dejó de ser actual. "Tiempo real" no es una frecuencia única. Hay tres momentos distintos: cuándo ocurrió el evento, cuándo llegó la señal y cuándo se actualizó la pantalla. Snowflake distingue en el mismo sentido entre la frescura del dato, la latencia de la consulta y el tiempo total hasta la decisión, y Grafana recomienda no refrescar más seguido de lo que cambia la fuente.
Tampoco hay que confundirlo con la velocidad de la interfaz. Los límites de respuesta de Nielsen (0,1, 1 y 10 segundos) hablan de cuánto tarda la pantalla en responder a una acción, no de cada cuánto se actualiza un sensor. Un clic en "reconocer alarma" necesita feedback inmediato aunque el dato del activo tenga dos minutos.
Esta es la tabla que uso para decidirlo con ingeniería. Son criterios cualitativos, no segundos normativos:
| Tipo de dato | Qué actualidad exige la decisión | Qué mostrar | Si queda desactualizado |
|---|---|---|---|
| Alarma crítica en curso | La que permita responder al incidente | Estado, prioridad, momento y responsable | Marcarla como no verificada y escalar por el canal de contingencia |
| Señal de una cámara | Suficiente para confirmar que se puede observar | Última señal y estado de comunicación | Mostrar "sin señal", no "apagada", si no está confirmado |
| Equipo IoT por zona | Según el ciclo de telemetría y el riesgo | Estado, hora de la última muestra y ubicación | Tratarlo como dato atrasado; no inferir normalidad |
| Alarma reconocida | Inmediata en la interfaz, confirmada por el backend | Reconocida o pendiente de confirmación, con autor | No presentar el reconocimiento como resolución |
| Tendencia histórica | Una ventana apta para comparar | Periodo, granularidad y huecos | Indicar el atraso de la fuente; no unir vacíos con una línea |
| Resumen por instalación | Tolera agregación | Total, anomalías y activos sin datos | Diferenciar "cero anomalías" de "no se pudo evaluar" |
La idea que más defiendo: el estado del dispositivo y la frescura del dato son dos dimensiones distintas. Un activo puede estar "armado" según su último dato y, al mismo tiempo, llevar veinte minutos sin enviar señal. Si la pantalla congela la última muestra en verde, el problema no es estético: la interfaz está afirmando algo que ya no sabe.
¿Cuándo conviene mantener información densa?
Cuando quien la usa es un experto que necesita comparar. La tentación de un rediseño es "limpiar": quitar columnas, espaciar, mostrar menos. En una consola operativa eso puede romper la tarea, porque el operador compara equipos, ordena por estado y salta entre activos. Lo que hay que eliminar no es información, sino información sin jerarquía.
En SIAC, uno de los problemas era justamente la densidad sin jerarquía clara. La respuesta no fue vaciar la pantalla, sino ordenar la tipografía, agrupar por tipo de activo y hacer que cada interacción diera una respuesta visual inmediata.
Con el movimiento pasa algo parecido: las micro-animaciones confirman una acción, pero si todo se mueve, compiten con la alarma. Las WCAG piden poder pausar, detener u ocultar el contenido que se actualiza solo en ciertos casos, y conviene respetar la preferencia de movimiento reducido. En una consola crítica, eso se resuelve sin esconder alarmas ni confundir un dato pausado con uno actual.
¿Cómo lo abordé en SIAC?
SIAC es una plataforma de monitoreo en tiempo real para operaciones industriales de gran escala. Unifica el estado de 20.347 activos críticos de cinco tipos (cámaras, sensores, gateways, maquinaria y personal) en un dashboard operativo. El sistema anterior cumplía su función técnica, pero no acompañaba la velocidad de la operación: estados poco diferenciados, acciones sin respuesta visual, densidad sin jerarquía y una navegación poco fluida entre alarmas, mapa y activos.
Seguí el método que aplico a cualquier producto B2B complejo:
- Modelé el sistema antes de la interfaz. Hice una auditoría UX del producto en uso: tokens de color y estados, flujos de alarmas, seguimiento y gestión de usuarios, y puntos sin feedback. El objetivo no era reemplazar todo, sino eliminar lo que obstaculizaba la operación.
- Simplifiqué los flujos que más cuestan. Reorganicé la interfaz para que lo crítico se leyera primero y las acciones frecuentes estuvieran al alcance: las alarmas se gestionan en pocos pasos, con resolución y reportes, y el mapa permite localizar cualquier incidente.
- Dejé un sistema reutilizable. Tokens por estado, tema oscuro con contraste optimizado y componentes para KPIs, tablas, mapas y alarmas, repartidos en 8 vistas conectadas con un mismo lenguaje visual.
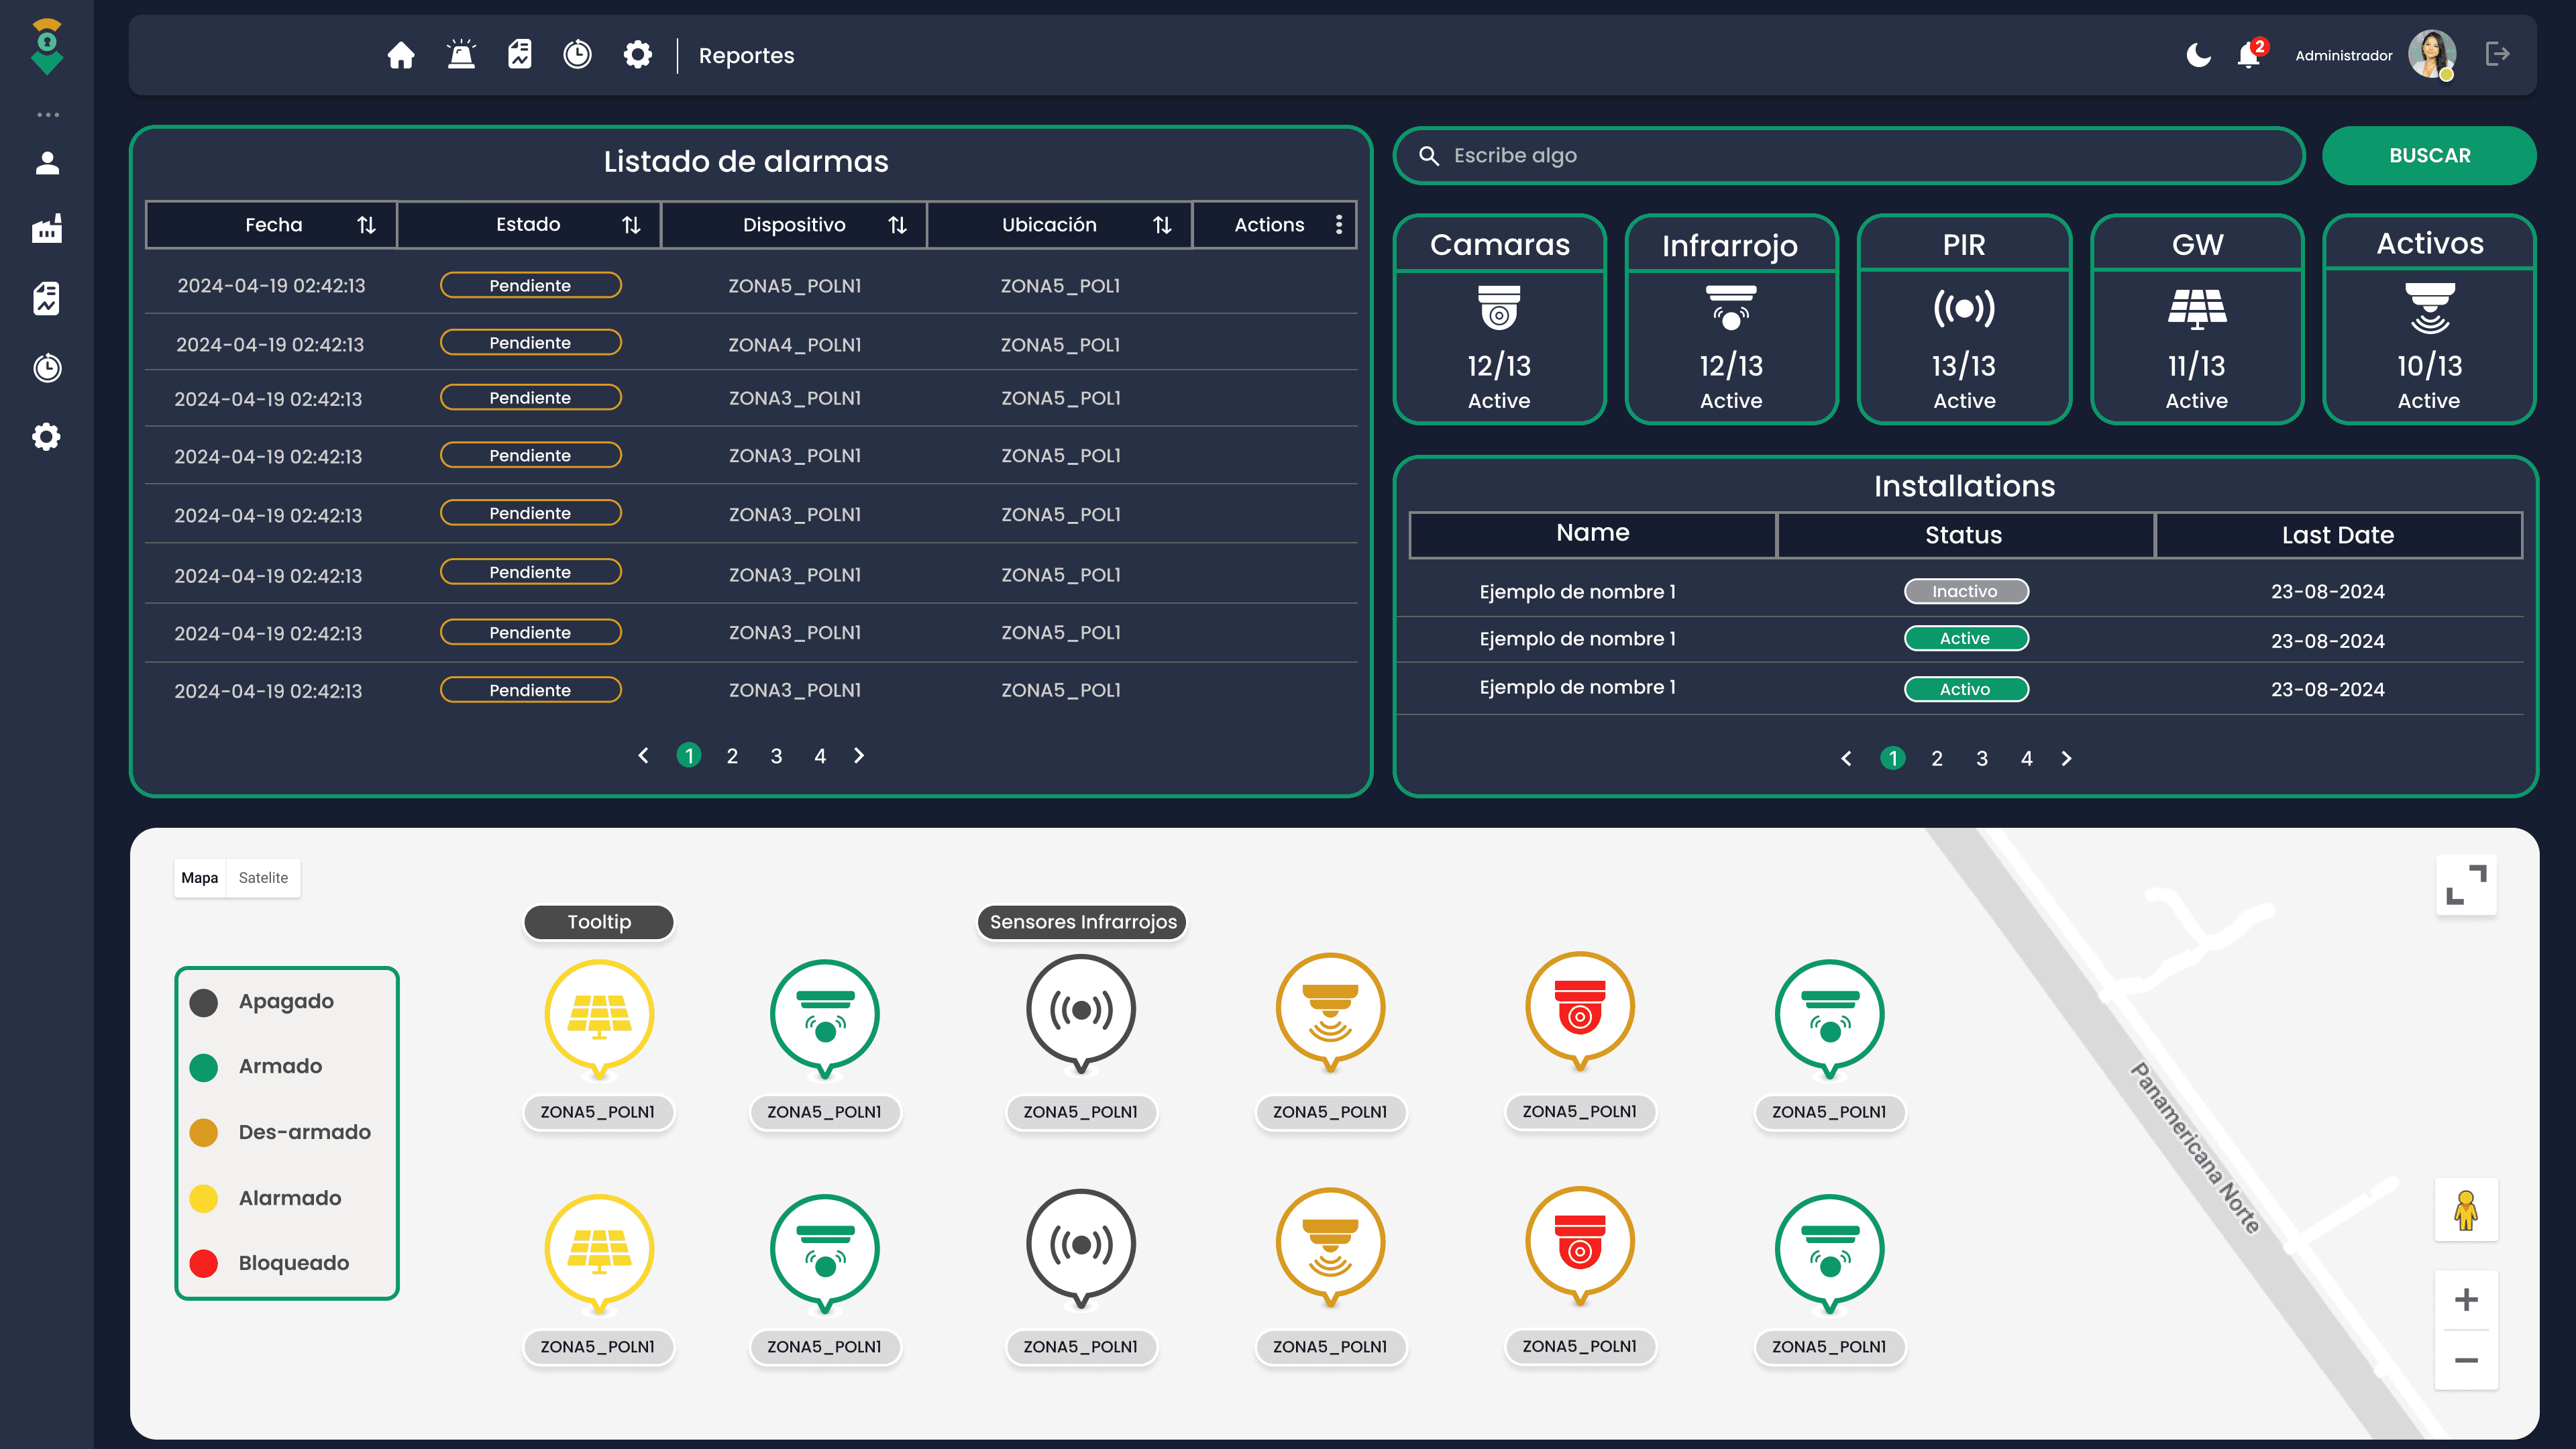
El rediseño está pensado para que los operadores lean una alerta crítica de un vistazo y pasen menos tiempo interpretando la interfaz. Es una intención de diseño: no tengo métricas medidas que la confirmen.
Dos autocríticas. La primera: SIAC usa verde para el estado armado, que en su dominio es normal. Tiene una ventaja clara, que es reconocer rápido un estado conocido. Pero las interfaces de alto desempeño de la industria de procesos tienden a reservar los colores llamativos para lo anormal, y muchas superficies verdes pueden restarle saliencia a una alarma. No son posturas excluyentes: dependen de si la tarea principal es reconocer estados o detectar excepciones. Lo resolvería comparando variantes con operadores, con tareas observables. La segunda: desarmado y alarmado usan tonos cálidos cercanos. La etiqueta de texto evita que dependan solo del color, pero agregaría una forma distinta por estado y probaría las pantallas sin color.
La idea que va contra el consejo habitual: en estado normal, un dashboard operativo debería ser casi aburrido. No es una ley universal, pero el color, el contraste y el movimiento son un presupuesto limitado: si los gastas en lo que está bien, no te quedan para lo que está mal.
¿Qué errores conviene evitar en un dashboard operativo?
Mostrar el último valor como si fuera actual. Un dato congelado en verde es más peligroso que un dato que dice "sin señal".
Tratar todo como alarma. Eventos, avisos y fallas de datos necesitan pesos distintos.
Afirmar mejoras sin línea base. Antes de decir que un rediseño redujo errores, hay que observar tareas reales y medirlas.
Auditoría de un dashboard operativo en 12 puntos
Puedes copiarla y aplicarla a tu propio producto:
- ¿Se reconoce el estado general sin leer todas las tarjetas?
- ¿Las excepciones que requieren acción se distinguen de inmediato?
- ¿Se llega de una alerta a su activo, ubicación y contexto en pocos pasos?
- ¿El estado de cada dispositivo se entiende sin color?
- ¿Los estados y sus transiciones están definidos con ingeniería?
- ¿Se distinguen evento, aviso, alarma y pérdida de señal?
- ¿Cada alarma tiene severidad, contexto, responsable y siguiente acción?
- ¿Reconocer, silenciar y resolver tienen significados y registros distintos?
- ¿Se muestra la antigüedad del dato cuando puede cambiar una decisión?
- ¿La interfaz diferencia "no hay problemas" de "no se pudo evaluar"?
- ¿Las tablas y filtros soportan trabajo experto bajo presión?
- ¿Se observaron tareas reales con operadores antes de afirmar mejoras?
¿Cuándo no aplica este enfoque?
Cuando el dashboard no se usa para intervenir. Si lo revisa un comité una vez por semana, es un reporte y conviene diseñarlo como tal. Tampoco tiene sentido trasladar normas de la industria de procesos a un producto donde nadie tiene que actuar en minutos: los principios sirven, las cifras no se copian.
Preguntas frecuentes sobre dashboards operativos
¿Qué diferencia hay entre un dashboard operativo y uno estratégico o analítico?
El operativo sirve para detectar y atender lo que pasa ahora; el analítico, para investigar causas con datos históricos; el estratégico, para revisar objetivos a mediano plazo. Pueden compartir datos, pero no la jerarquía ni el ritmo de lectura.
¿Cómo se priorizan las alarmas en un dashboard industrial?
Separando eventos, avisos, alarmas accionables y fallas de datos, y asignando a cada alarma severidad, responsable y siguiente acción. En la industria de procesos, ISA-18.2 y EEMUA 191 son las referencias para gestionar alarmas como un ciclo de vida.
¿Se puede usar solo el color para indicar el estado de un equipo?
No. Las WCAG piden que el color no sea el único medio para transmitir información, y en operación dos tonos parecidos se confunden. Combínalo con una etiqueta visible y un ícono o forma.
¿Qué hacer si un dato de sensor está desactualizado o sin conexión?
Mostrarlo: indica la hora de la última señal y marca el dato como atrasado o sin señal. "No se pudo evaluar" es una respuesta válida; un verde congelado, no.
¿Con qué frecuencia hay que actualizar un dashboard en tiempo real?
Con la que exige cada decisión: una alarma crítica, la señal de una cámara y una tendencia histórica tienen necesidades distintas. Lo obligatorio en todos los casos es mostrar cuándo el dato dejó de ser actual.
¿Qué hacer si tu dashboard ya existe pero tu equipo reacciona tarde?
Empezar por entender qué hace el operador cuando algo falla: qué mira, qué no encuentra y en qué momento duda. Casi siempre el problema no está en un gráfico, sino en estados mal definidos, alarmas que no se distinguen y datos que no dicen cuándo dejaron de ser confiables.
En mi servicio de Complex Product Design trabajo esa secuencia: audito el flujo operativo, modelo estados y alarmas con producto e ingeniería, rediseño las tareas críticas y dejo componentes reutilizables. Si tu plataforma de monitoreo ya está en uso y cuesta leerla bajo presión, podemos revisar juntos por dónde empezar.
Volver al blogServicio relacionado
¿La complejidad del producto está frenando al equipo?
Ordeno flujos, roles, datos y reglas para que el producto deje de frenar al equipo que lo usa.