Human in the loop: supervisar agentes de IA
Human in the loop para agentes de IA: cómo definir autonomía, aprobar excepciones, intervenir y auditar decisiones. Un caso de diseño B2B.
Cuando un producto empieza a delegar decisiones en agentes de IA, la conversación suele terminar en un botón: "el humano aprueba". El botón resuelve la reunión, pero no el problema. Si la persona no entiende qué está aprobando, aprueba en serie. Si todo le llega con la misma urgencia, deja de mirar. Y si la única forma de corregir es apagar todo, nadie lo hace a tiempo.
En este artículo explico cómo diseño esa capa de supervisión, con un caso propio: Sentinel OS, un sistema para que una persona coordine una flota de agentes. También lo uso para criticar mis propias decisiones de diseño.
¿Qué es human in the loop cuando un agente de IA puede actuar?
Es el modo en que una persona tiene que decidir antes de que el agente ejecute una acción. Conviene distinguirlo de otros dos modos:
- Human in the loop: el agente propone y la persona aprueba, edita o rechaza antes de que ocurra algo.
- Human on the loop: el agente actúa solo y la persona supervisa, con capacidad de intervenir o revertir.
- Fuera del loop: el agente actúa y la persona solo audita después, si audita.
Una aclaración necesaria: en machine learning, "human in the loop" también nombra a las personas que etiquetan datos o corrigen un modelo durante el entrenamiento. No hablo de eso. Hablo de supervisión humana de decisiones operativas en un producto que ya está funcionando.
¿Cuánta autonomía conviene delegar a un agente de IA?
No hay un nivel único para todo el sistema. Parasuraman, Sheridan y Wickens propusieron hace más de dos décadas que cada función automatizable (adquirir información, analizarla, decidir y ejecutar) puede tener su propio nivel de automatización. Aplicado a agentes, eso significa separar la decisión de la acción: un agente puede analizar y proponer solo, y aun así necesitar autorización para ejecutar algo irreversible.
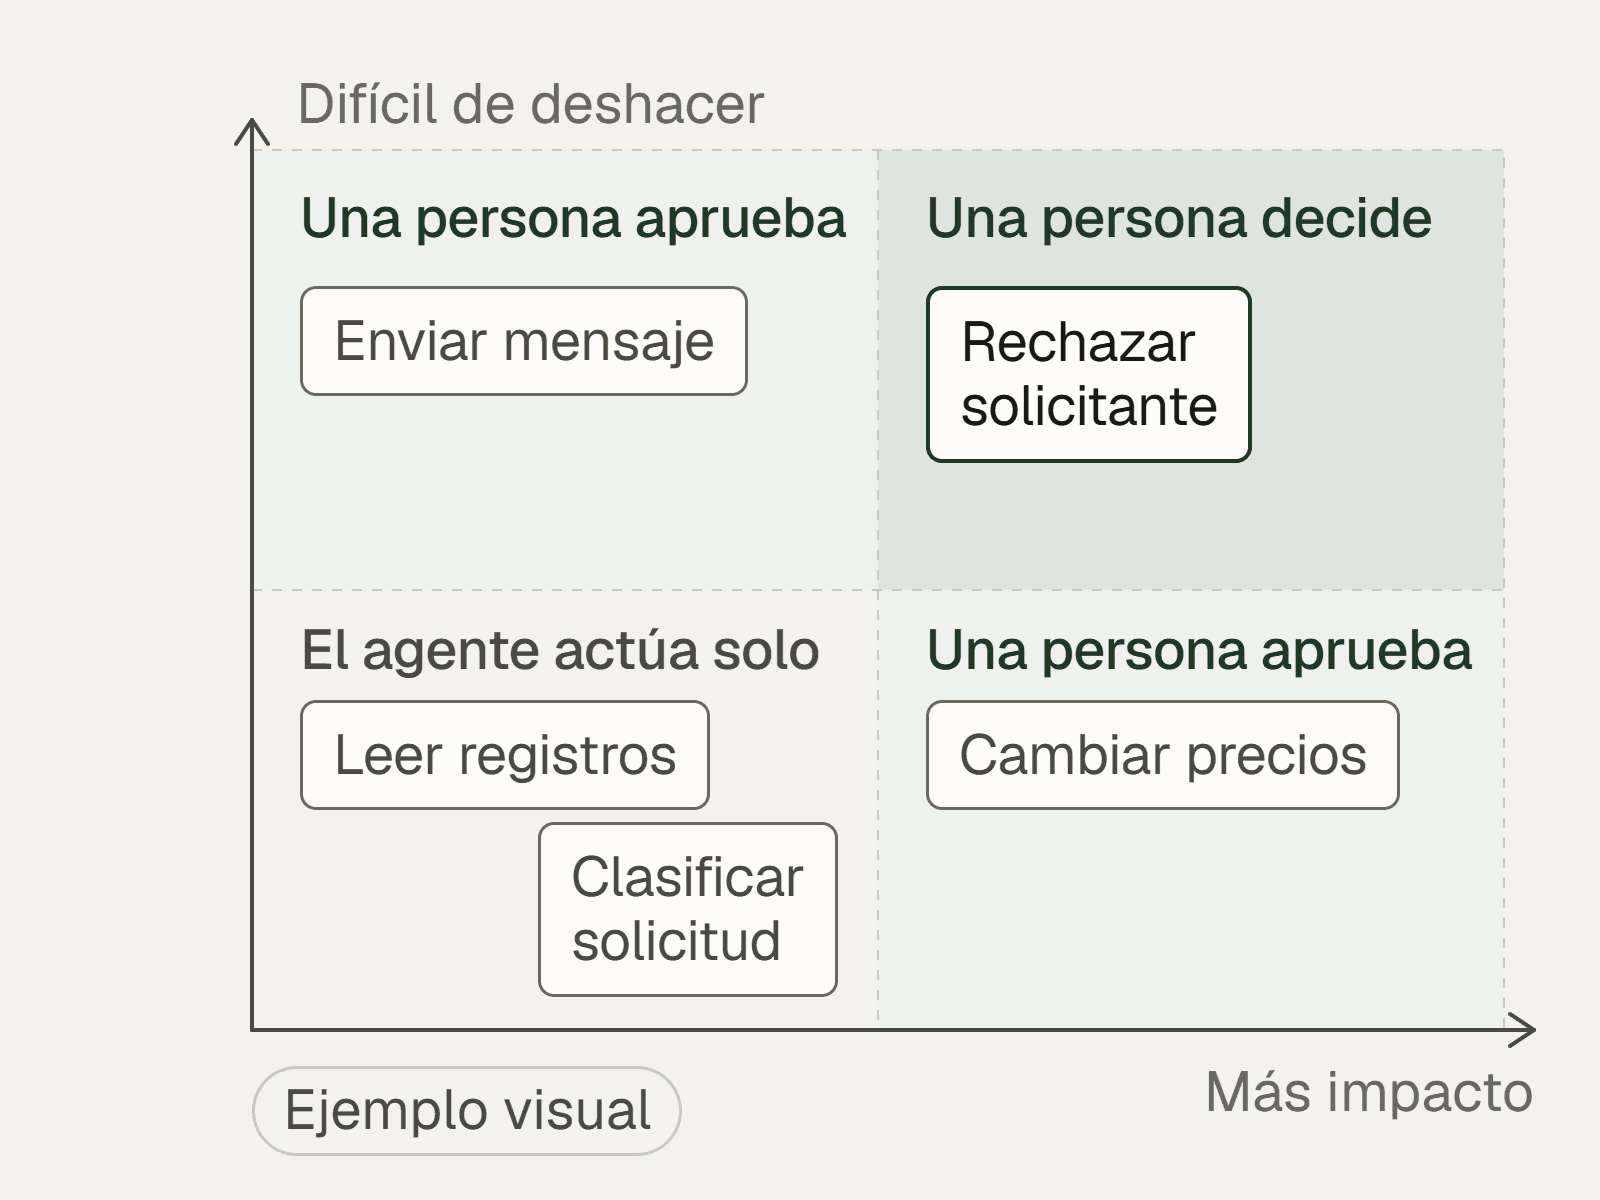
Para decidir el modo de cada acción uso dos preguntas: ¿se puede deshacer de verdad? y ¿cuánto daño hace si sale mal? La tabla es una propuesta de criterio con ejemplos hipotéticos, no una regla universal ni un resultado medido:
| Acción del agente | ¿Se puede deshacer? | Impacto si sale mal | Modo de supervisión | Qué tiene que ver la persona |
|---|---|---|---|---|
| Leer registros sin modificarlos | Sí, no cambia nada | Bajo si los permisos son correctos | Autónomo, con registro y límites de acceso | Qué leyó y con qué permisos |
| Clasificar una solicitud comercial | Sí | Medio: puede sesgar la priorización | Autónomo, con auditoría por muestreo | Reglas usadas, datos faltantes, errores repetidos |
| Enviar un mensaje a un lead | Antes del envío sí; después, no | Medio o alto: privacidad y reputación | Human in the loop antes de enviar | Destinatario, texto exacto, contexto y motivo |
| Cambiar el precio de varios inmuebles | Parcialmente, aunque exista rollback | Alto y con efecto en cadena | Comprobaciones automáticas más aprobación previa | Precio actual y propuesto, origen del cambio, agentes que dependen de él |
| Rechazar a un solicitante de arriendo | Difícil para la persona afectada | Alto, sobre derechos de terceros | Decisión humana con revisión especializada | Datos verificables, razones, responsable y forma de corregir |
En Sentinel lo resolví con un umbral de confianza configurable: por encima, el agente actúa solo; por debajo, pide aprobación. En el onboarding el rango va de 58 % a 95 %, con 75 % por defecto, y cada tipo de agente puede tener su propio umbral.
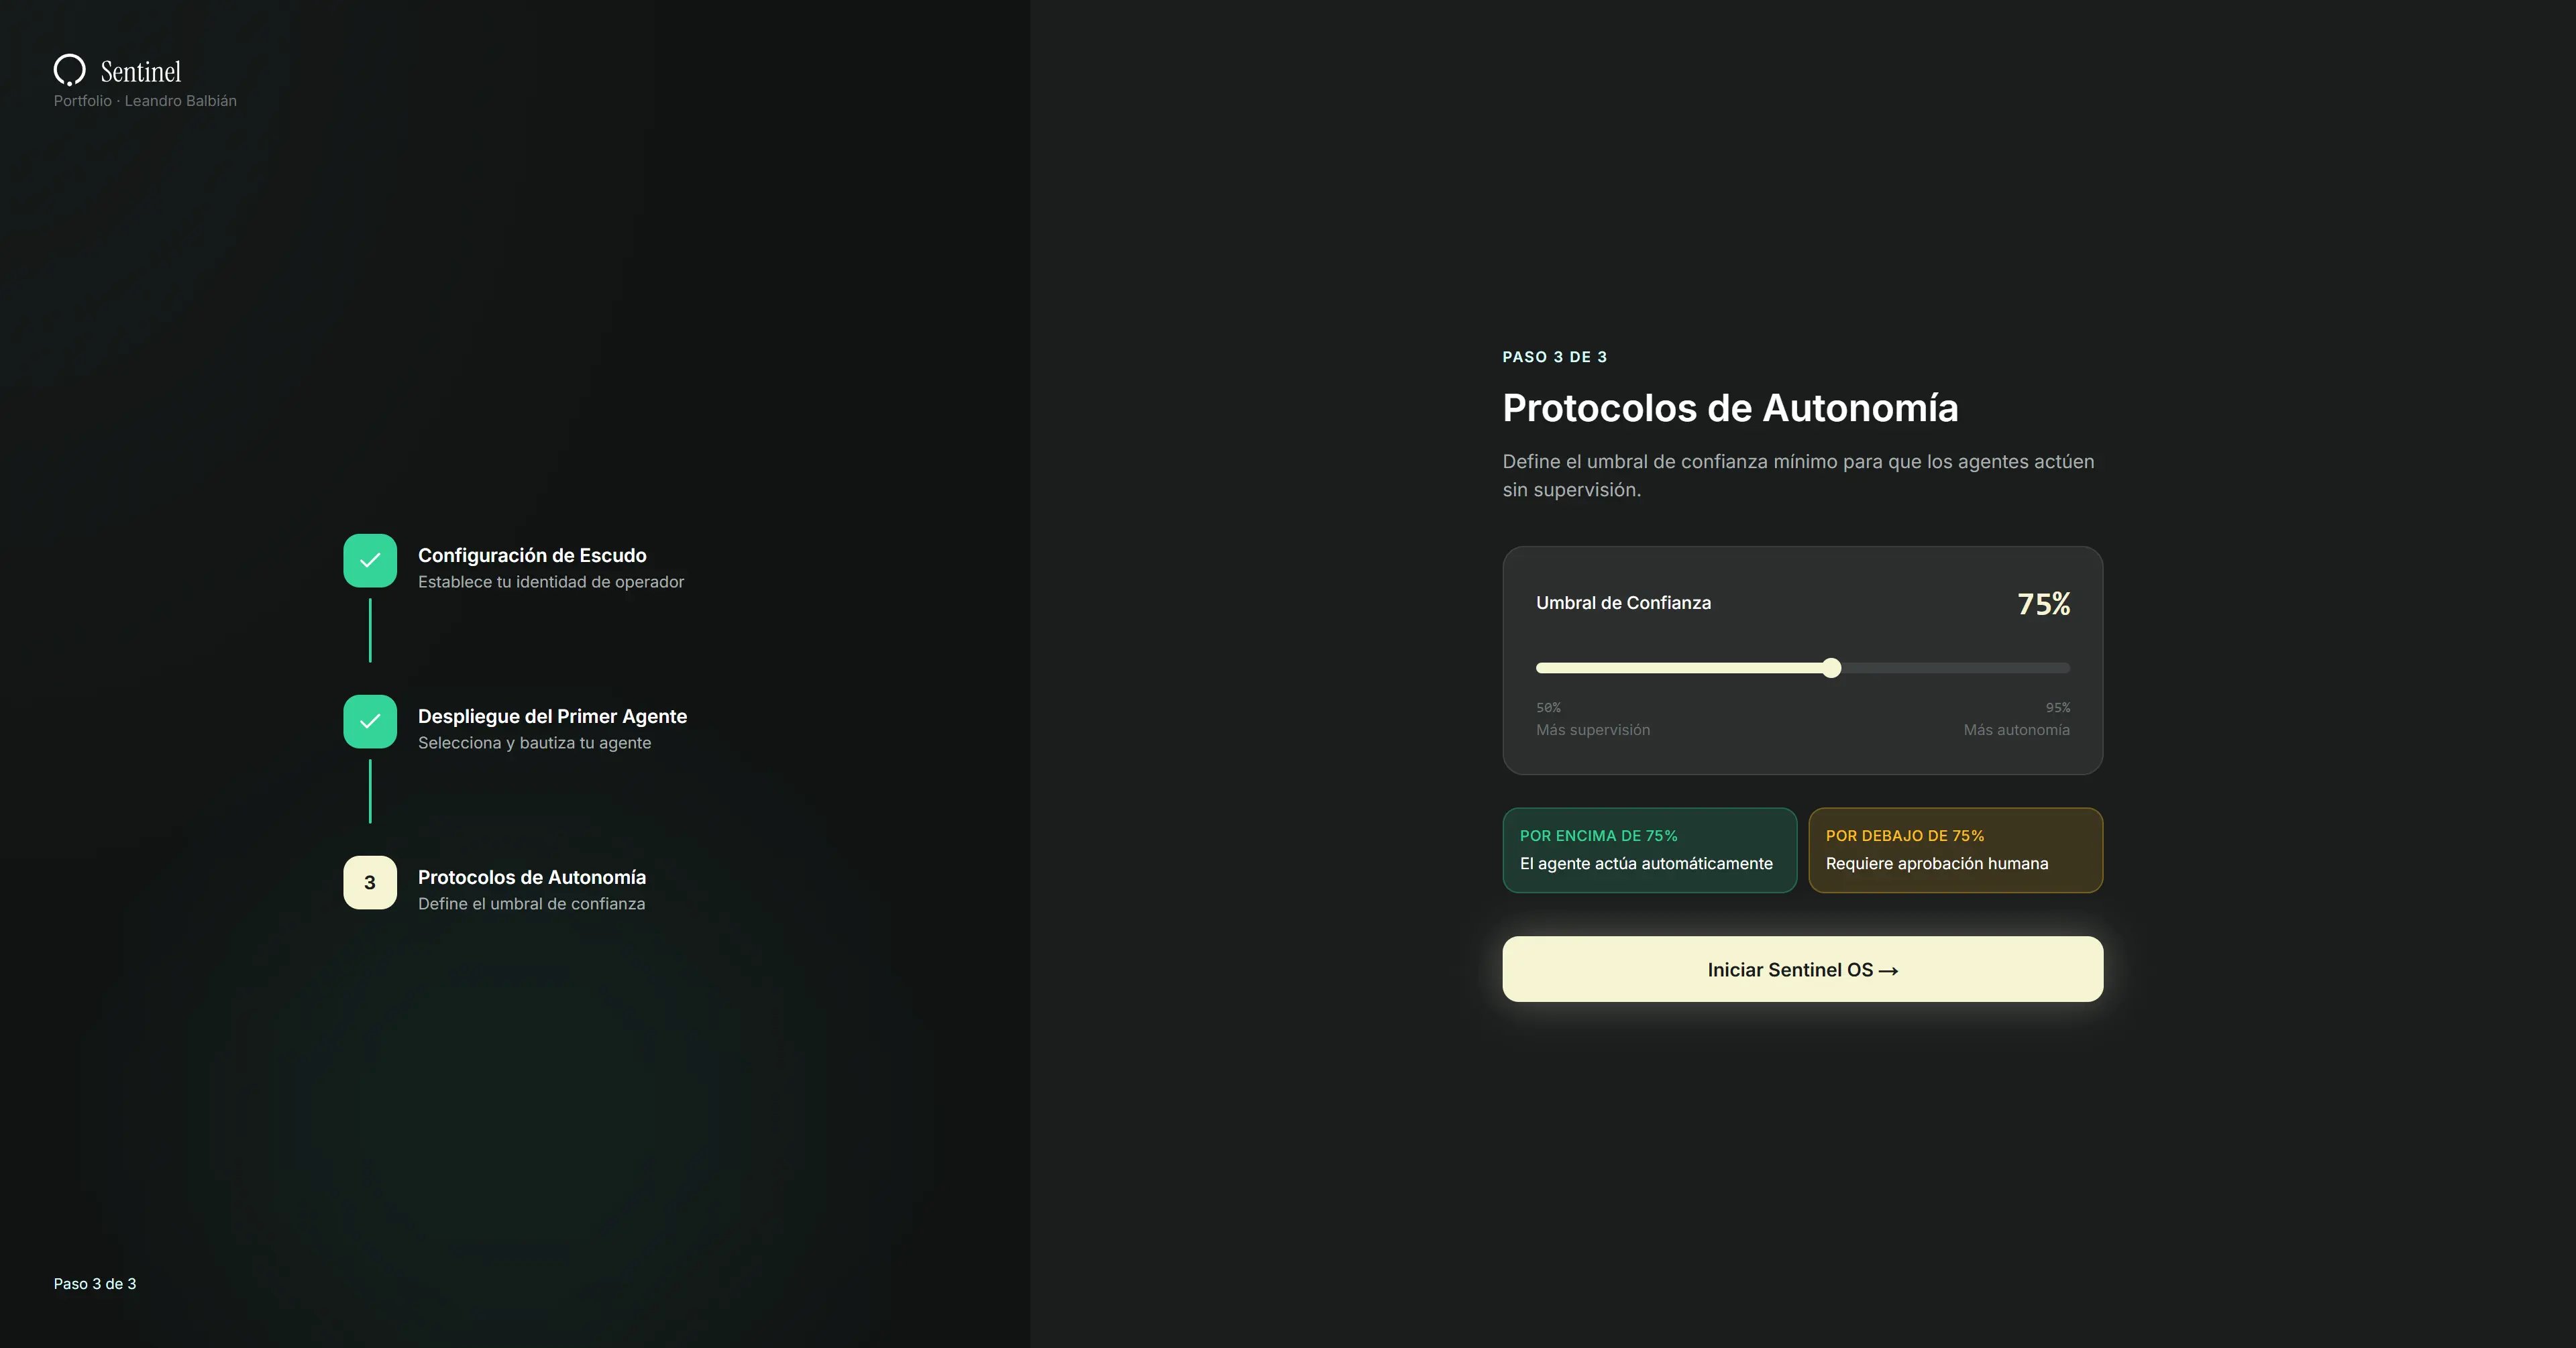
Hoy lo diseñaría distinto. Ese 75 % es un parámetro de demo, no una probabilidad de acierto. La confianza que expresa un modelo de lenguaje tiende a estar sobreestimada y varía según el modelo y la tarea. Además, la guía de Google PAIR advierte que un indicador de confianza puede malinterpretarse, y a veces conviene no mostrarlo si no mejora la decisión. Un score alto nunca debería autorizar por sí solo una acción: los permisos, los límites de monto, la reversibilidad y las comprobaciones fuera del modelo tienen que decidir antes.
¿Cómo se diseña una cola de supervisión por excepción?
Mostrando solo lo que cruza un umbral de riesgo y ordenándolo por impacto. En Sentinel, la vista "Para revisar" lista únicamente las decisiones que necesitan a una persona, priorizadas por impacto económico. El resto de la flota trabaja sin pedir atención.
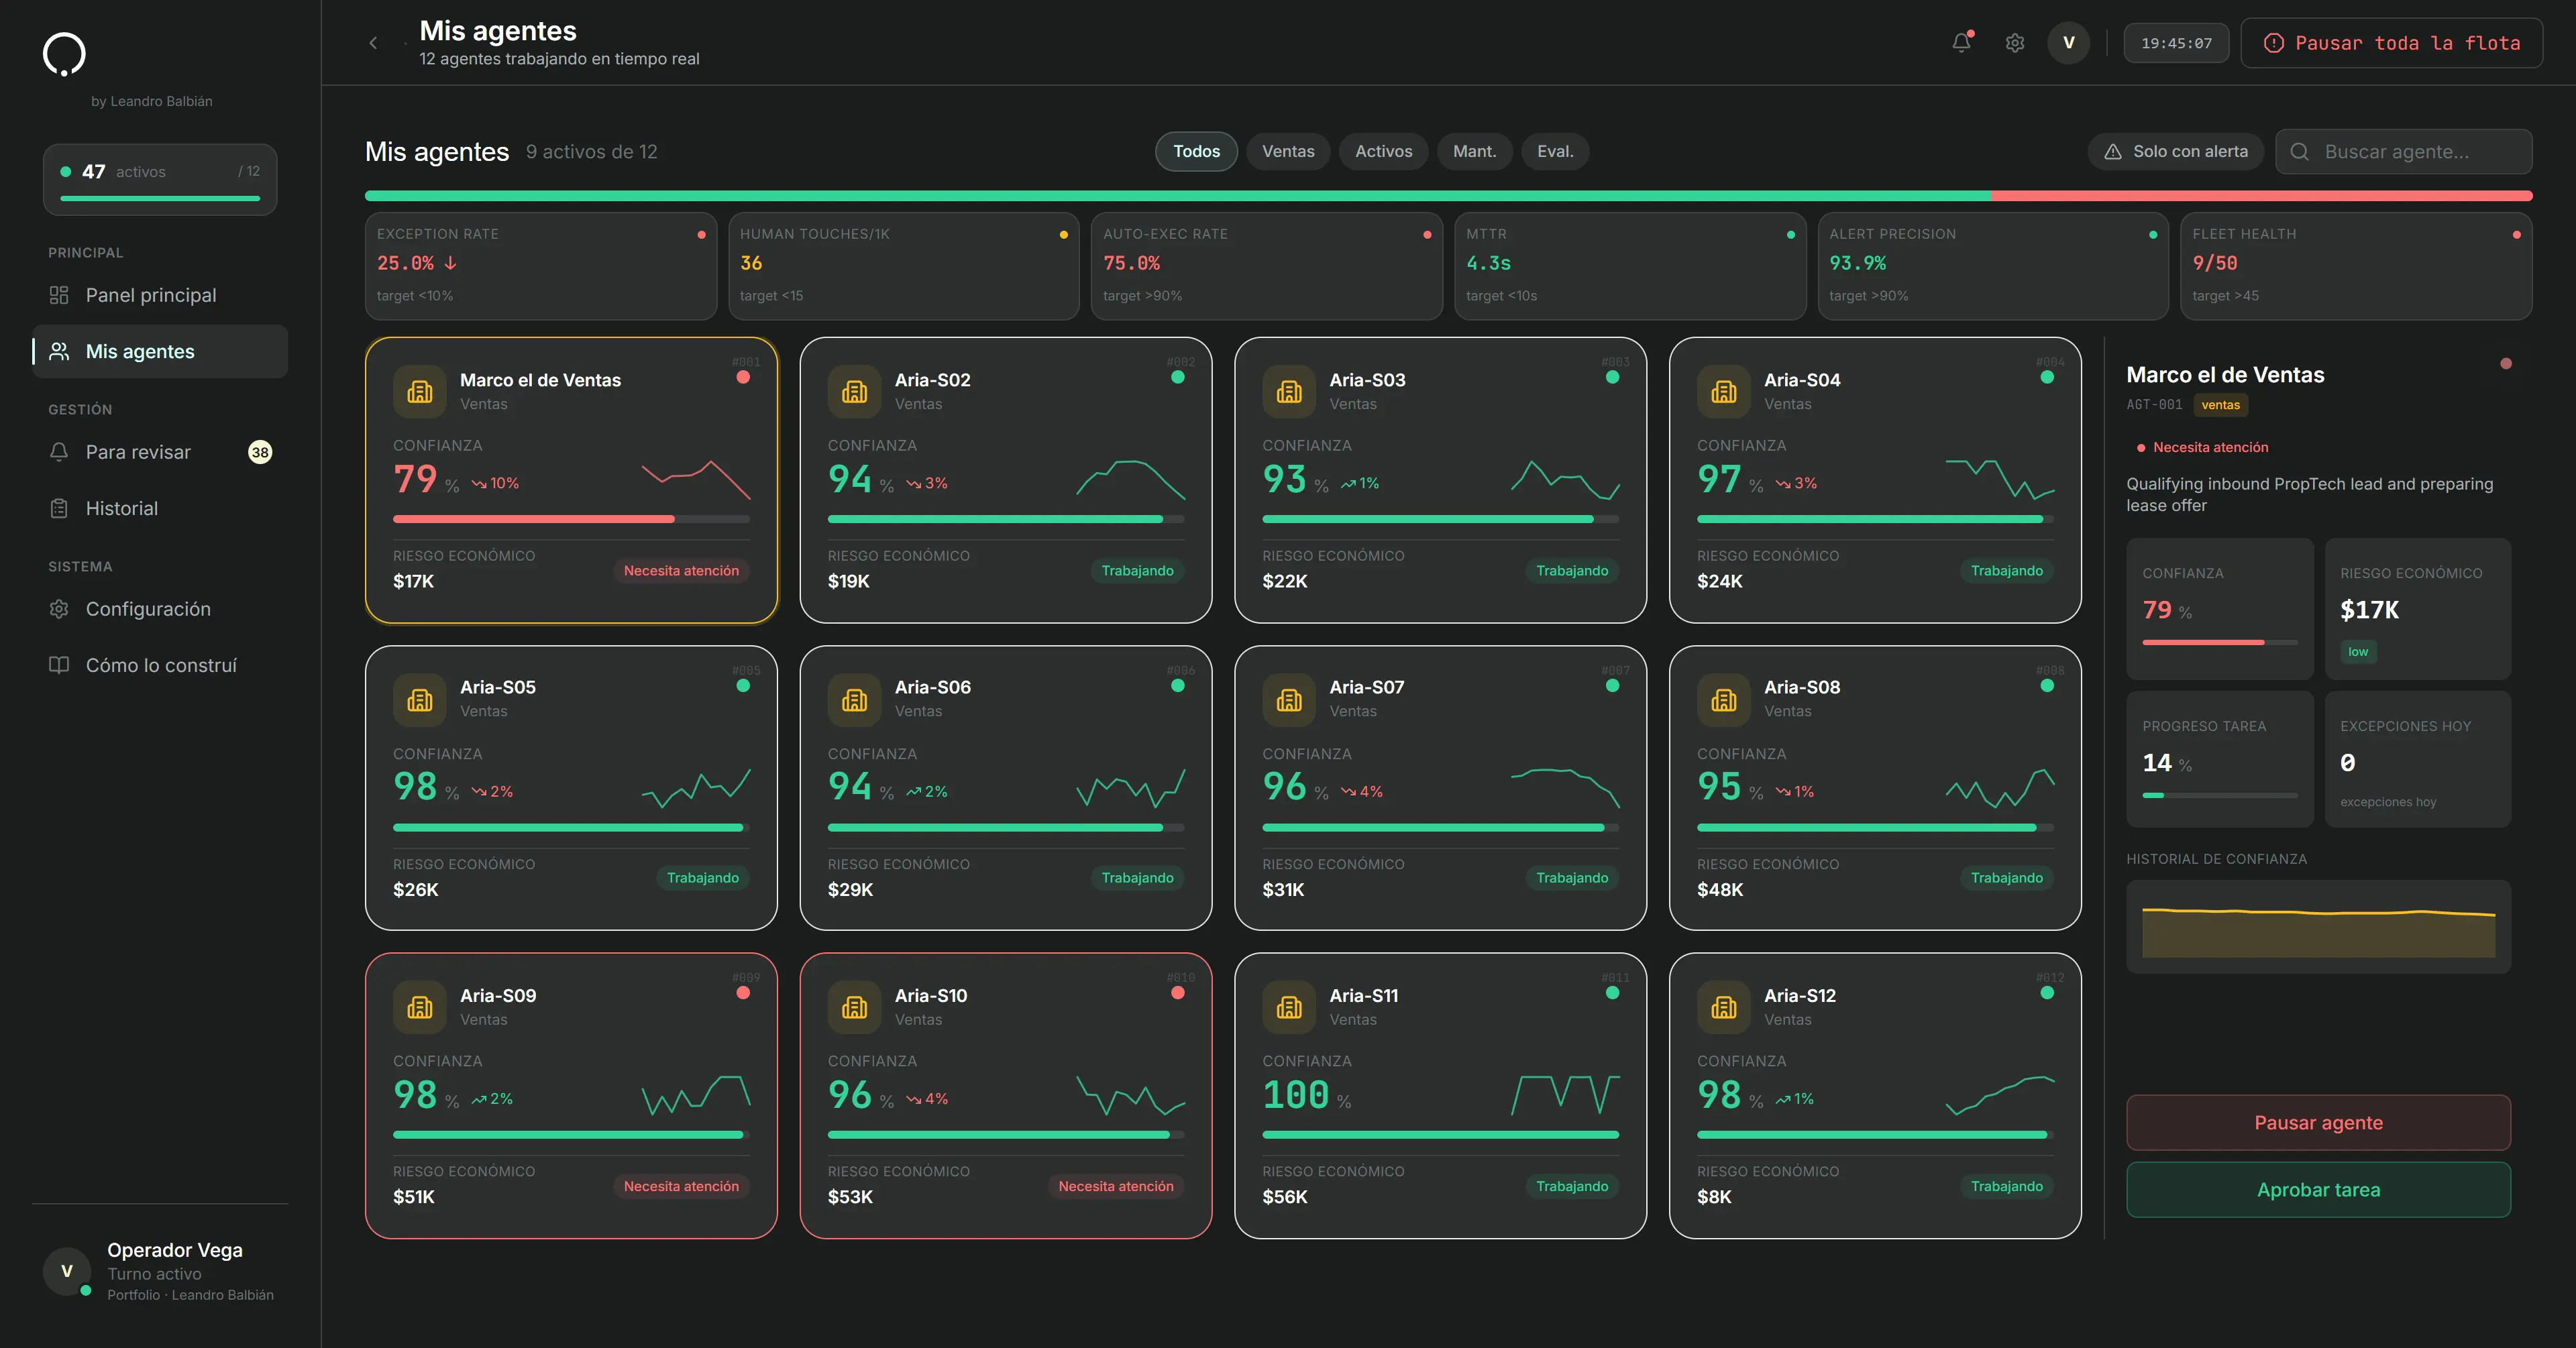
Pero una cola corta no sirve si cada elemento no trae lo necesario para decidir. Esta es la lista que uso para diseñar cada excepción. Puedes copiarla tal cual:
- Qué acción exacta propone el agente y con qué parámetros.
- Qué agente la propone, en nombre de quién y con qué permisos.
- Qué cambia: el estado actual frente al propuesto.
- Por qué llegó a revisión: qué regla, umbral o anomalía la escaló.
- Qué fuentes consultó, de cuándo son y qué datos faltan.
- La confianza, solo si está definida y calibrada, con lo que significa.
- El impacto económico, operativo y sobre personas, separando estimación de hecho.
- Qué otros agentes o acciones dependen de esta decisión.
- Cuánto tiempo hay para decidir y qué pasa si nadie responde.
- Las opciones reales: aprobar, editar, rechazar, pedir información, derivar o pausar.
- Si se puede deshacer y cómo. Un mensaje enviado no se deshace con un botón.
- Quién aprobó, cuándo, con qué versión de la política y qué se ejecutó de verdad.
La idea que va contra el consejo habitual. Más aprobaciones no hacen un sistema más seguro: trasladan el riesgo a la atención de una persona. La investigación sobre complacencia y sesgo de automatización muestra que la supervisión humana nominal no elimina los errores, sobre todo con carga multitarea. Anthropic describe el mismo fenómeno en agentes como fatiga de aprobación: cuando todo pide permiso, las personas aprueban sin leer.
El contraejemplo es mío. En Sentinel diseñé la aprobación en un clic para que la cola avanzara rápido. Para decisiones rutinarias funciona. Para las de alto impacto es un riesgo: convierte la revisión en un gesto mecánico y da una falsa sensación de control. La corrección no es agregar fricción a todo, sino escalarla con el riesgo: decisión rápida para lo menor; diff, evidencia, impacto y confirmación explícita para lo que no se puede deshacer.
¿Cómo intervenir sin detener a todos los agentes?
Con contención gradual. Uno de los problemas que definí al empezar Sentinel era la intervención binaria: o dejas correr a la flota, o la apagas entera. Con 50 agentes, apagar todo por un error es tan caro que nadie lo hace a tiempo.
Diseñé cuatro niveles de contención por agente:
- Solo leer: el agente sigue consultando, pero no puede modificar nada.
- Congelar: detiene su trabajo en curso.
- Sin acceso: pierde el acceso a las herramientas y los datos.
- Suspender: sale de operación.
La pausa de emergencia también tiene alcance: puede detener toda la flota o solo a los agentes que están dando error, y exige escribir "PAUSAR" para confirmar.
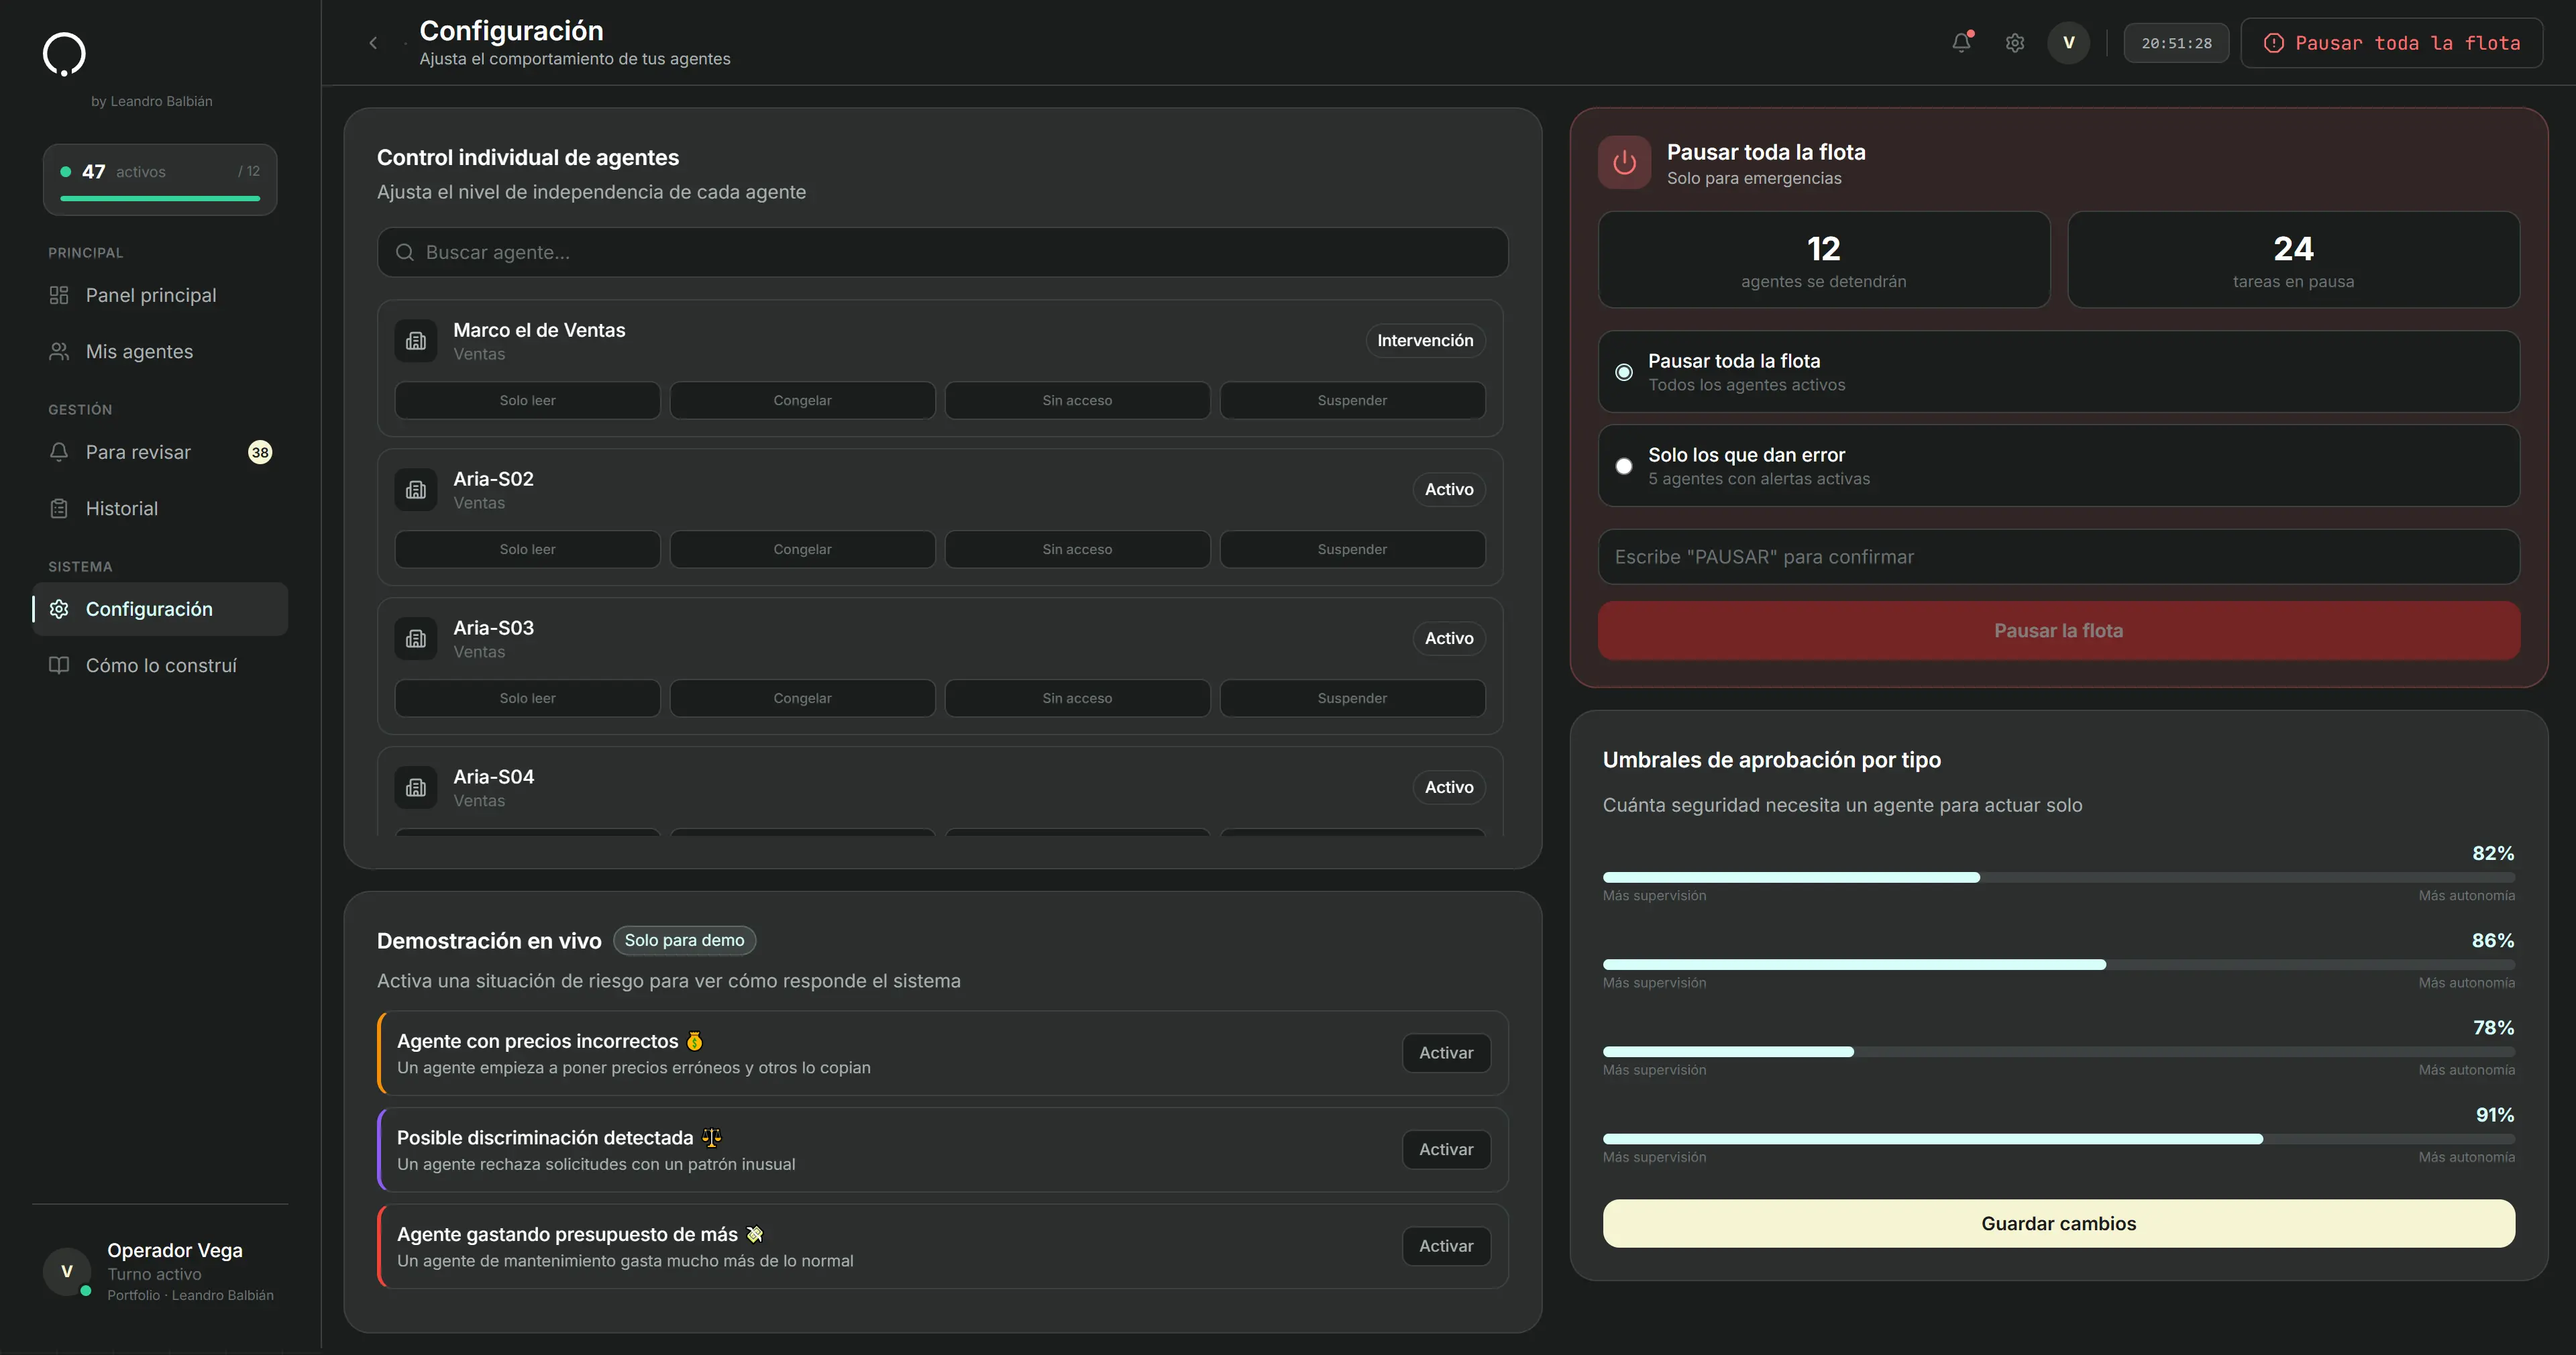
La idea toma el principio del patrón circuit breaker, que en software corta las llamadas a un servicio que falla para evitar fallas en cascada. Pero los cuatro niveles de Sentinel no son ese patrón al pie de la letra: son modos de operación y permisos. Antes de construirlos hay que definir con ingeniería qué significa cada uno, porque detener la escritura, revocar credenciales y pausar la ejecución no son lo mismo.
El escenario de prueba fue un price loop: un agente empieza a poner precios incorrectos y otros lo copian. En la simulación, la respuesta correcta no era apagar la flota, sino pasar a "solo leer" a los agentes afectados, cortar la propagación e investigar la dependencia.
¿Qué tiene que guardar el historial de decisiones de un agente?
Lo suficiente para reconstruir una decisión sin depender de la memoria de nadie: entradas, herramientas usadas, fuentes, parámetros, la regla que se aplicó, quién aprobó y qué se ejecutó de verdad. En Sentinel, cada decisión se descompone en pasos, fuentes y confianza histórica.
Dos precisiones. La primera: el historial tiene que mostrar acciones y evidencias auditables, no pretender que expone el razonamiento interno del modelo. La segunda: OpenAI advierte que la aprobación humana no reemplaza los controles de permisos del servidor. Un botón de aprobar en la interfaz no es una autorización si el backend no la verifica.
¿Cómo diseñé Sentinel OS y qué falta validar?
La pregunta de origen fue: ¿cómo puede una persona coordinar, confiar y corregir a 50 agentes de IA sin perderse en el ruido? El escenario eran agentes que toman decisiones en paralelo en ventas, gestión de activos, mantenimiento y evaluación de inquilinos, con un único operador.
Seguí el mismo orden que uso en cualquier producto B2B complejo: primero modelo el sistema y después la interfaz. Aquí eso significó definir la autoridad antes del dashboard:
- Seis estados del agente y sus transiciones: idle, running, monitoring, intervention_required, circuit_open y suspended.
- Cuatro perfiles de agente con umbrales de riesgo distintos.
- Reglas de escalación por confianza, riesgo económico y dependencias cruzadas.
- Tres escenarios de riesgo para probar la intervención: price loop, screening bias (un agente rechaza solicitudes con un patrón inusual) y retry storm (un agente de mantenimiento gasta mucho más de lo normal).
Después simplifiqué los flujos que más cuestan, que son revisar una excepción y contener a un agente, y los dejé como componentes reutilizables. El detalle está en el caso de Sentinel OS.
Lo que falta es lo más importante. Antes de llevarlo a producción haría pruebas con operadores reales y mediría:
- cuántas propuestas erróneas detectan;
- cuánto tardan en decidir según la severidad;
- cuántas aprobaciones cambian después de abrir la evidencia;
- cuánto tardan en contener a un agente sin detener a los sanos.
También calibraría el score de confianza por tipo de decisión o lo reemplazaría por señales de riesgo explícitas. Hasta entonces, el sistema es una hipótesis de diseño bien construida, no un resultado.
¿Qué enseña Ghosts sobre saber cuándo no actuar?
Ghosts es un prototipo validado con dirección en un marketplace inmobiliario B2B en México, anonimizado. Es una cola para rescatar leads que nadie atendió: un asistente redacta un mensaje y el asesor revisa quién era el cliente, ajusta el texto y lo envía por su cuenta. La regla no se negocia: ningún mensaje se envía sin que una persona lo apruebe. Lo describo dentro del recorrido completo en cómo recuperar leads perdidos en un marketplace inmobiliario.
Lo más útil para este tema son sus reglas de intervención, porque deciden cuándo el sistema no actúa:
- un contacto de más de 60 días recibe una propuesta de reporte trimestral por correo, y la llamada en frío queda prohibida;
- un teléfono inválido manda el caso a cuarentena;
- los números quedan enmascarados hasta que el asesor acepta el caso.
Para el piloto definí metas, no resultados: respuesta positiva de al menos 25 %, primer contacto en menos de 90 minutos y descarte o queja por debajo de 5 %. Un buen producto de automatización se define más por lo que decide rechazar que por lo que ejecuta a ciegas.
¿Qué errores convierten la supervisión humana en un trámite?
Mostrar todo con la misma urgencia. Si cada alerta pesa igual, ninguna pesa. La cola tiene que ordenarse por impacto. Con las alarmas de un sistema de monitoreo pasa lo mismo; lo explico en cómo diseñar dashboards operativos en tiempo real.
Usar la confianza del modelo como permiso. Un número alto no reemplaza los límites de acción, monto y reversibilidad.
Ofrecer solo "aprobar". Sin editar, rechazar o pedir información, la persona no tiene autoridad real sobre la decisión.
Llamar reversible a lo que no lo es. Revertir en la interfaz no borra un correo enviado ni una respuesta comunicada a un tercero.
Diseñar solo el botón de apagado. Una parada global es necesaria, pero no es un plan de contingencia.
¿Cuándo no necesitas este enfoque?
Cuando el agente hace un solo paso determinista, de bajo riesgo y sin efectos externos, una cola de excepciones es burocracia. Alcanza con registros y una auditoría periódica.
Tampoco lo necesitas cuando la decisión tiene que ser siempre humana. Ahí el agente puede preparar la información, pero el producto no debería ofrecer modo autónomo.
Preguntas frecuentes sobre human in the loop en agentes de IA
¿Cuál es la diferencia entre human in the loop y human on the loop?
En human in the loop, la persona decide antes de que el agente ejecute. En human on the loop, el agente actúa solo y la persona supervisa, con capacidad de intervenir o revertir. Un mismo producto suele combinar los dos según el riesgo de cada acción.
¿Hay que aprobar todas las acciones de un agente de IA?
No. Aprobar todo genera fatiga y aprobaciones sin lectura. Lo razonable es reservar la aprobación previa para acciones irreversibles o de alto impacto, y dejar el resto en modo autónomo con supervisión y auditoría.
¿Conviene mostrar la confianza del agente en la interfaz?
Solo si está definida, calibrada por tipo de decisión y probada con quienes la van a leer. Si no, puede dar una falsa seguridad. A veces es mejor mostrar por qué la decisión llegó a revisión que mostrar un porcentaje.
¿Qué exige el artículo 14 del Reglamento de IA de la UE?
Que los sistemas de IA de alto riesgo se diseñen para una supervisión humana efectiva: la persona debe poder entender sus limitaciones, detectar anomalías, tener presente el sesgo de automatización, desestimar o revertir resultados y detener el sistema. Tras la modificación de 2026, buena parte de esas obligaciones se aplica desde el 2 de diciembre de 2027. No aplica igual a cualquier agente: depende de la categoría del sistema, y es una pregunta para asesoría legal.
¿Se puede deshacer lo que hizo un agente?
Depende de la acción. Un cambio interno puede tener rollback; un mensaje enviado o una decisión comunicada a una persona, no. Por eso la reversibilidad se diseña antes de dar autonomía, no después del error.
¿Qué hacer si tu producto ya delega decisiones en agentes de IA?
Empezar por el modelo, no por la pantalla: qué decide cada agente, con qué permisos, qué escala, quién responde y cómo se corrige. Cuando esas reglas están claras, la interfaz de supervisión es mucho más simple de diseñar.
En mi servicio de Complex Product Design trabajo esa secuencia: modelo roles, estados y reglas de autoridad, simplifico los flujos de revisión e intervención y dejo componentes que ingeniería puede reutilizar. Si tu equipo está sumando agentes a un producto B2B, podemos revisar juntos dónde poner el control.
Volver al blogServicio relacionado
¿La complejidad del producto está frenando al equipo?
Ordeno flujos, roles, datos y reglas para que el producto deje de frenar al equipo que lo usa.